AI翻訳の競争力は、もはやモデルの大きさでは決まらない
鍵を握るのは、その組織だけが使う「用語」である
AI翻訳の進化は、長らく「より大きなモデル」をめぐる競争として語られてきた。だが企業の現場で起きている問題は、少し違うところにある。翻訳の成否を分けているのは、一般的な文章をどれだけ自然に訳せるかではない。その組織と業界だけが使う用語を、どこまで正確に理解しているかだ。
モデルの規模では、もう差がつかない
新しいモデルが登場するたびに、より自然な文章、より多くの対応言語、より高い翻訳精度が強調されてきた。業界の側も、モデル規模とベンチマーク性能を軸に進歩を測ってきたと言っていい。
しかし企業の現場では、別の問題が表面化している。
同じイベントの中でさえ、製品名がセッションごとに異なる訳語になる。ひとつの研究プロジェクトが、資料によって別の名前で表記される。医薬品名が一般名詞のように訳されることもあれば、投資関連の発表で「Series A」が投資ラウンドではなく文字通りの意味で処理されてしまう例もある。
これらは、言語を理解できていないために起きる誤りではない。文脈(Context)を理解できていないために起きる誤りである。
そう捉え直すと、企業向けAI翻訳の競争軸も見えてくる。最大の言語モデルを持つプラットフォームではなく、組織の文脈と用語を最もよく理解しているプラットフォームが評価される。そんな時代に入りつつある。
翻訳は「言語」ではなく「知識」の問題になった
この10年で、企業間のコミュニケーションは急速に専門化した。今日の国際会議は、もはや一般的な会話の場ではない。
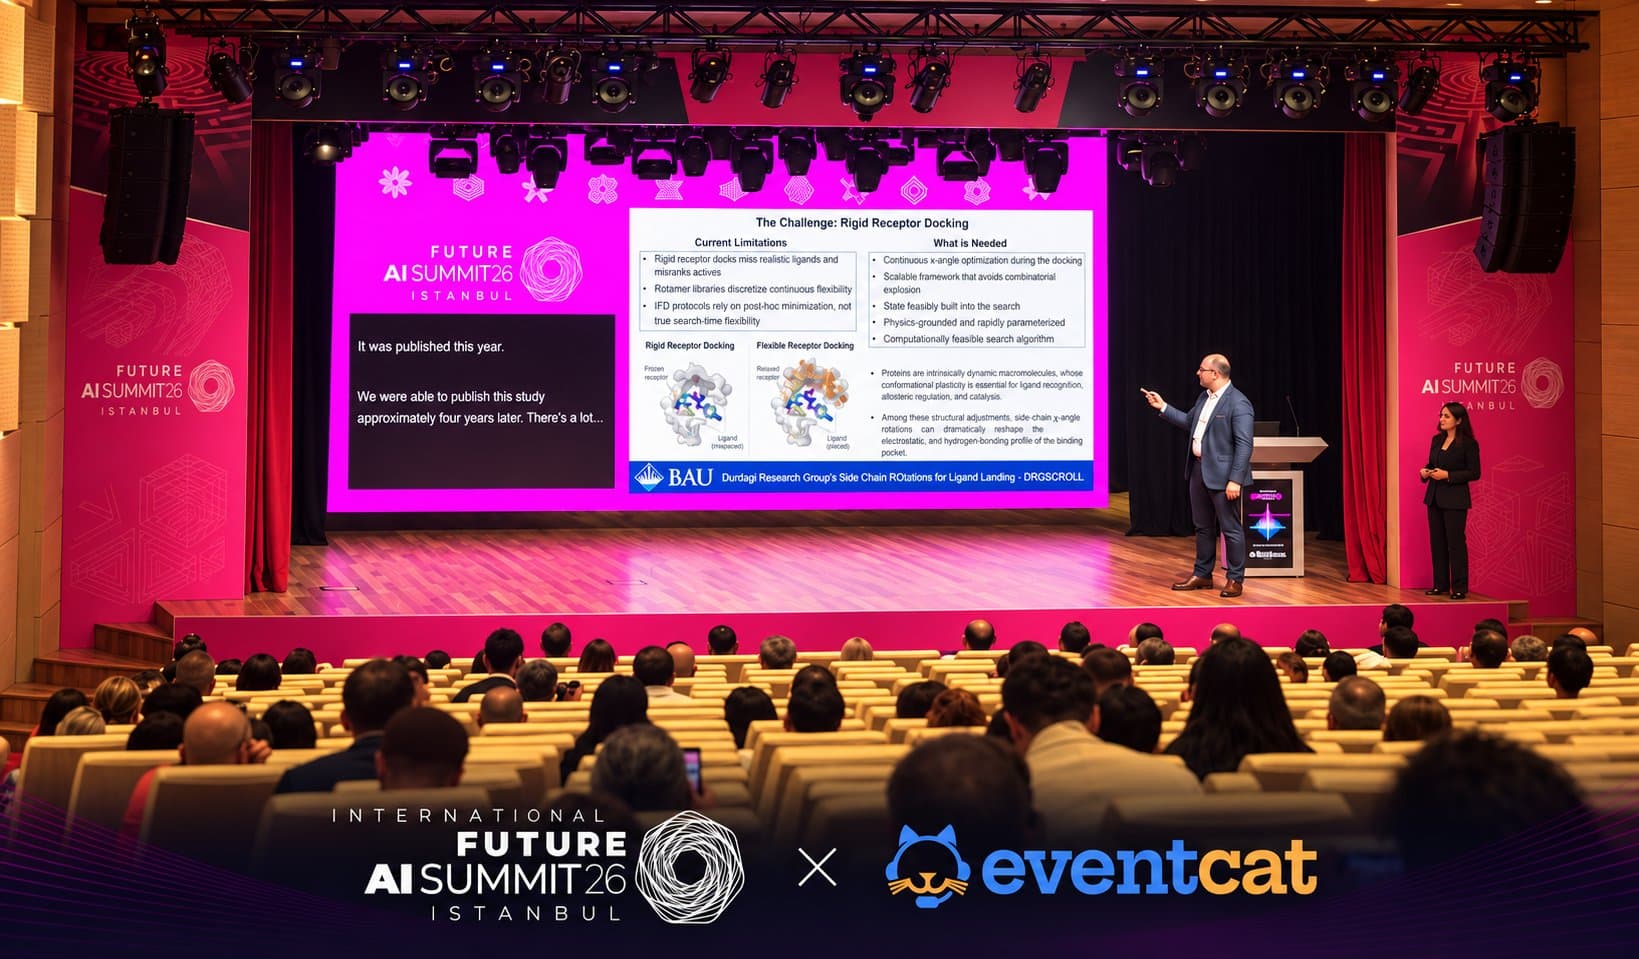
医療系の学会では臨床試験と規制の用語が飛び交う。半導体カンファレンスではプロセスノードやチップアーキテクチャが中心言語になる。スタートアップイベントではSAFE、Series A、CAC、LTV、Product-Market Fitといった言葉が当たり前に登場し、大学の学術大会では研究センター名や研究課題名が発表の重要な文脈を形づくっている。
興味深いのは、こうした単語こそが発表の核心だという点だ。
「Good morning」の訳が多少ぎこちなくても、気に留める聴衆はほとんどいない。ところが主力製品名や政府事業名、臨床プロトコルが誤訳された瞬間、発表全体の信頼性は一気に損なわれてしまう。
日本企業に引き寄せて考えると、事情はさらに複雑だ。社名や製品名の英文表記が部署ごとに揺れている、正式名称と通称が併存している、といったケースは珍しくない。AIに訳させる以前の段階で、組織の中で表記そのものが定まっていない。そんな例も少なくないだろう。
結局のところ、企業環境における翻訳品質は、AIが言語をどれだけ理解しているかよりも、その組織が使う文脈をどれだけ正確に把握しているかで決まりつつある。
リアルタイム翻訳では、その差がさらに開く
この変化は、リアルタイム通訳の現場でより鮮明になる。
文書翻訳であれば、あとから確認して修正する時間がある。リアルタイム通訳にその余裕はない。国際会議のメインスクリーンに社名が誤って表示された瞬間、あるいは同じ技術用語が登壇者ごとに違う訳語で出た瞬間、それはそのまま参加者の体験になってしまう。
リアルタイム翻訳では、AIが後から意味を推論する時間が存在しない。必要な文脈は、発表が始まる前にすでに用意されていなければならない。
用語集は「翻訳機能」ではなく「組織の知識」である
多くの組織は、いまだに用語集(Glossary)を翻訳ツールの一機能程度に捉えている。だが、その位置づけは変わりつつある。
用語集とは、ある企業や機関がどのような言葉で世界と向き合っているかを記録したもの。すなわち組織の知識(Organizational Knowledge)に近い性質を持つ。
製品名、ブランド名、プロジェクト名、法人名、公式の略語、専門用語。これらはすでに組織の中に存在している。必要なのは新しい情報をつくることではなく、その知識をリアルタイム翻訳の前にAIへ届ける仕組みだ。
この視点に立つと、用語管理(Terminology Management)は翻訳品質を底上げする付加機能ではなくなる。AI翻訳の土台を形づくる工程そのものである。AIに推測を委ねるのではなく、組織が自ら文脈を提供する。企業環境では、推論よりも文脈のほうが良い結果を生むことが多い。
進化はモデルの中ではなく、その周辺で起きている
企業向けAI翻訳で近年最も興味深い変化は、言語モデル自体ではなく、その周辺で進行している。
用語データベース、発表資料、登壇者情報、製品カタログ、社内文書。こうした組織の知識をAIに接続する動きが広がってきた。発表中にAIがすべてを自力で推論することを期待するのではなく、重要な情報を先回りして渡しておく発想である。
この手法がもたらす効果は、翻訳精度の向上だけにとどまらない。登壇者やセッションが変わっても、一貫したコミュニケーションを維持できるようになる。
設計思想に表れ始めた転換
こうした潮流は、多言語コミュニケーションを扱うプラットフォームの設計にも反映され始めている。
たとえばEventCATは、より大きな言語モデルで問題を解こうとするのではなく、発表前にAIへ組織の文脈を理解させる方向を選んでいる。GlossaryとSTT Revise Guideを使い、発表資料、会社名、製品名、専門用語、登壇者情報といった要素を、あらかじめ翻訳プロセスに反映させる仕組みだ。
背景にあるのは、多言語イベントが決して汎用的な環境ではないという認識である。国際会議も、投資家向け説明会も、学術大会も、それぞれ固有の言語と業界、参加者を抱えている。
AIが発表前に理解している文脈が多いほど、リアルタイムで推測しなければならない情報は減る。結果として、参加者が受け取るコミュニケーションの一貫性と信頼性は高まっていく。AI翻訳の品質を決めるのは翻訳エンジンだけではない。組織がどれだけ自らの知識を準備したかも、同じくらい効いてくる。
最良の翻訳は、マイクが入る前に始まっている
言語モデルは、これからもさらに速く、さらに自然になっていくだろう。だが企業向けAI翻訳プラットフォームの競争力が、言語モデルだけで決まる可能性は低い。
企業は製品、研究、規制、ブランド、そして蓄積された専門性を軸にコミュニケーションを行っている。こうした組織の文脈を理解する翻訳システムは、言語処理だけを担うシステムよりも安定して高い品質を出し続けるはずだ。AI翻訳の競争力は、言語(Language)から知識(Knowledge)へと移りつつある。同時に、事前準備の重みも増している。
最良の翻訳は、発表が始まった瞬間に生まれるものではない。マイクが入るずっと前から始まっているのだ。
AI翻訳が次に問うべきこと
これまでAI翻訳の業界は、「機械により多くの言語を理解させるにはどうすればよいか」という問いに向き合ってきた。
これからは、問い方を変える必要がある。
そのAIは、自社が使っている言葉を理解しているか。
企業向けAI翻訳の競争力は、文章をどれだけ流暢に訳せるかではなく、組織が使う用語と文脈をどこまで深く理解しているかで決まっていく。そしてその差こそが、「正確な翻訳」と「信頼できるコミュニケーション」を分ける基準になる。